“好事怎么总让别人摊上”是一句针对流程的抱怨,而不是针对任务。它之所以挥之不去,是因为流程不可见:没人看得出某位同事为什么被挑中,于是“没有理由”就被怀疑填满。
一次随机抽取并不会让分配变得均等。它让理由变得可见,而这才正是人们真正在反对的部分。
随机分配做了什么
它把你从决定中移开。 不是移开你的判断,而是移开你的挑选。哪些任务存在、每个大约花多久,仍然由你决定。你不再做的,是挑选谁干什么——这一步无论是不是偏袒,都会被人读成偏袒。
它给每个人平等的机会。 是均匀,不是均等。在短时间内,有人会连着两次抽到下下签。这一点值得当面向团队说清楚,否则他们就会得出结论说流程坏了。
它给你留下记录。 一张同时显示名单和结果的截图,比一句“我是公平的”更有说服力,因为后者无法证伪。
它做不到什么
它不会平衡工作量。 随机分配给出的是相等的概率,不是相等的付出。把一个十分钟的任务和一个两小时的任务放在一起轮换,会产生一个数学上公平、实质上不均的一周,而你的团队会正确地称它不公平。
要在抽取之前解决,而不是之后:要么把大任务拆开,要么把这种不均衡当面说明。行不通的做法是照抽不误,然后指望没人注意。
它不考虑技能。 如果一项任务需要资质,随机化就注定有时会让不合适的人拿到它。这类任务要有意安排,其余的再随机化。
它处理不了依赖关系。 如果一项任务必须在另一项之前完成,就把它们排序,而不是配对。
它不是排班表。 四周里,四次随机抽取不会让每个人工作量相同。如果那才是要求,你需要一份公开的轮换表,而抽取只能用在确实需要它的部分。
建立一个站得住的轮换
列出人员。 两个人同姓时用全名,否则结果会因为一个技术性理由被质疑。
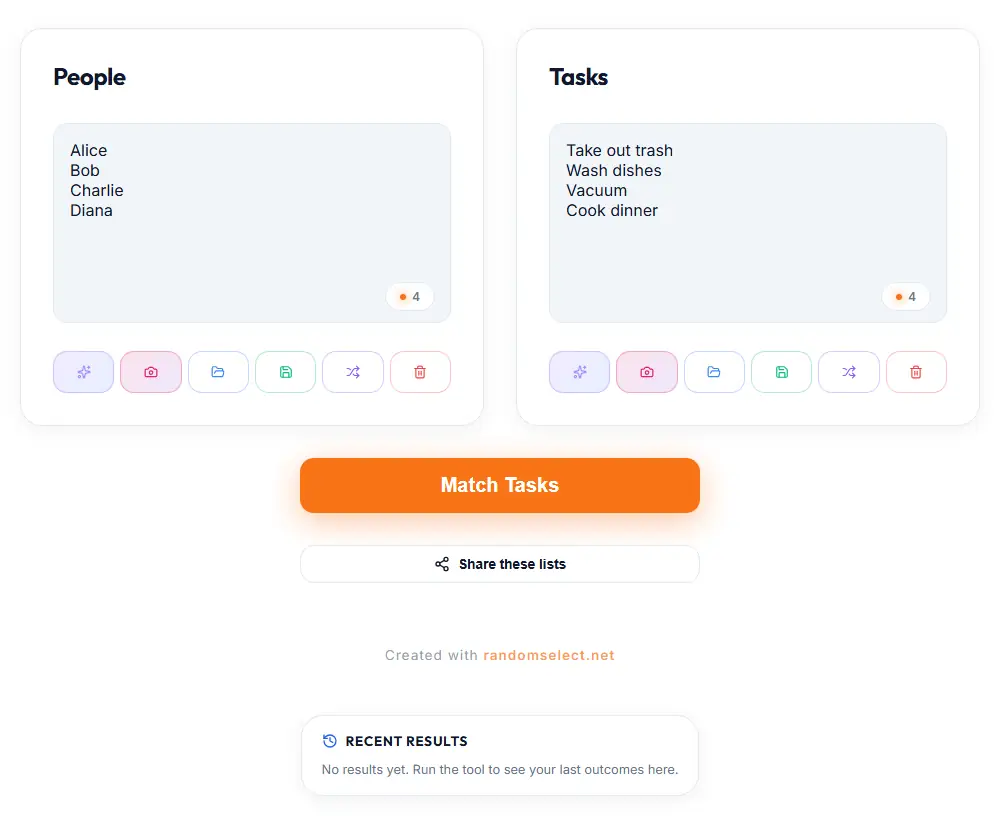
把任务列成可比的单位。 不要写“厨房”和“账务”——那是不同的工作量。如果一个是另一个的三倍,要么把它拆成三份,要么在轮换前按权重分组。
把两份名单都存下来。 每周重新敲一遍,正是搞死轮换的原因。我的收藏 最多保存五份,在浏览器里无需账号即可使用,登录后可跨设备同步。
固定一个日子。 绑定在一个触发点上的抽取——周一站立会、月末、某个班次模式的开始——才是轮换。临时来一次只是个姿态。
一个月后复盘。 看谁实际拿到了什么,而不是抽取记录说了什么。这是大多数团队会跳过的一步,也正是你发现某项任务耗时是预想两倍的地方。
什么时候当着人抽
如果流程会被质疑,就在看得见的地方运行它。录屏时把参与者名单一起录进去,或者当着团队的面运行。
这不是为了演戏。而是一次没人见证的随机过程,和一次有偏见的过程无从分辨,所以见证者才让这个差别从空口宣称变成真实。
一次性分配
这是另一种模式。对单个任务,从自愿者名单里抽一个人,或者如果这个任务确实是大家共担的,就从所有人里抽。
不要为一项已经有人自愿承担的任务抽名字——那既浪费了这份自愿,也制造出一种奇怪的义务。
任务分配 处理配对的情形:一边是人,一边是任务,一次操作完成匹配。它会报告未分配的任务,而不是悄悄丢掉,这在数量除不尽的时候很重要。
背后的方法是什么
抽取用的是浏览器的密码学随机源,而不是 Math.random(),后者是可预测的——它的输出原则上可以通过重建内部状态来预判。对于一份会被人检查的轮换表来说,这个区别是主张的实质,而不是技术细节。公平性页面 有更完整的解释。
一个现实的预期
随机性是实现程序公平的方式,而不是实现实质公平的方式。它保证你没有偏袒任何人。它不保证每个人都过了一个好的一周。
采用得好的团队,往往会在其上加一条刻意的例外——为抽到最差活的人固定安排一次短期的豁免——并让这条规则保持不变。随机性应对的是“流程有偏见”的质疑;这条固定例外应对的是“流程太盲目”的质疑。两者都需要。
开始上手
写下人员和任务。让任务在体量上可比。把它们载入任务分配,保存两份名单,在一个固定的日子抽取,坚持一个月。最后,看看实际的分配结果。
第一个月总有点不均匀。第二个月会好一些,到第三个月就没人再检查了。