大多数名单生成并不是创意问题,而是打字。内容都在你脑子里,前面却有四十分钟的输入工作,而内容本身想出来只要三十秒。
工具栏里的 Fill with AI 按钮去掉了打字这一步。你描述名单,它就出现了。这是一个很窄的功能,而知道它窄在哪里,比知道它能做什么更重要。
它是怎么工作的
这个按钮位于每个基于名单的工具的工具栏里——转盘、随机抽奖、随机分组、任务分配等等。点一下,输入提示词,生成的条目就会替换输入框里的内容。
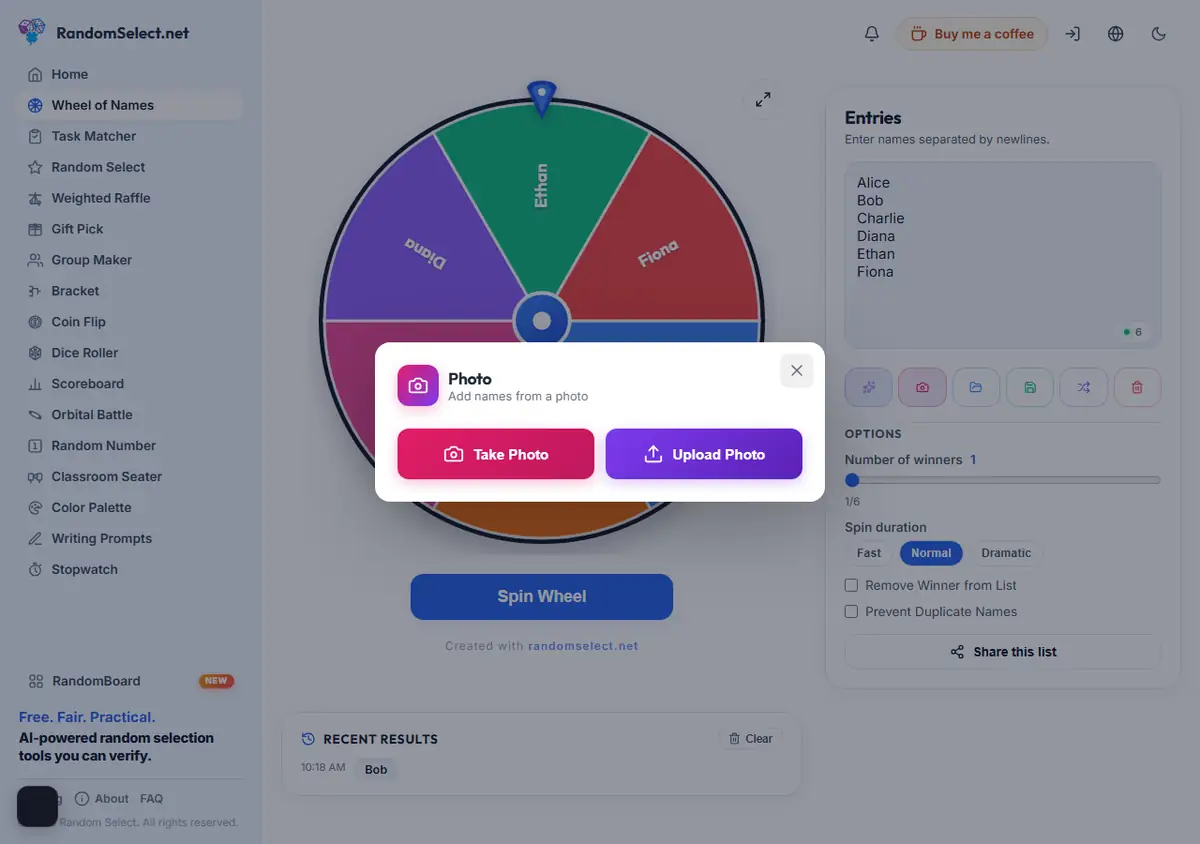
输出是纯文本,每行一个条目,由通过 Groq 推理服务运行的语言模型生成。它会用你写提示词时所用的语言回应,所以土耳其语提示词返回土耳其语结果,阿拉伯语提示词返回阿拉伯语结果。
有效的提示词
规律是一致的:把数量和类别说具体。
好的例子:
- “列出土耳其的 81 个省”
- “瑞典常见的 30 个名”
- “15 个欧洲首都城市”
- “10 个适合远程团队的团建活动”
- “20 个奇幻角色名字”
较弱的例子:
- “列一些名字”
- “给我点创意”
- “知识竞赛用的东西”
区别在于:第一种告诉模型要多少个、要什么,第二种把两者都留给它去猜。模糊的提示词产出模糊的名单——你问了二十个,往往只给你三个。
因为系统提示词是针对事实性枚举调校过的,基于数量的请求最可靠。要求列出全部 81 个土耳其省份的提示词,就能得到全部 81 个。
它有帮助的地方
用于测试的占位数据。 构建一份 200 个名字的名单,确认你的分组设置和抽取数量行为正常,然后删掉它。这是最常见的用法,也最省时间。
在选项之间做决定。 生成一份贴近真实的名单,用两个工具各试一遍,看看你更愿意拿哪一个展示给班级。名单是可丢弃的,决定不是。
你不会手动输入的名单。 手敲三百个条目是十五分钟的空耗。一句话只要一秒。
起步内容。 一份知识竞赛问题清单、一组项目创意、一组队名——这些是你会再去编辑的起点,生成十个再扩到五十个,比直接写十个更快。
不该使用它的地方
真实的参与者名单。 这是最重要的一条。生成的名字不是报名者。如果你在抽取奖品并公布结果,名单池里的每个名字都必须属于一个真实报名的人。生成出来的“Elif Yılmaz”是一个看似合理的角色,而不是参与者。
你已经持有的名单。 如果参与者在一个表格、一张照片或一份报名表单里,那你手上就有真实名单。生成一个它的近似版本,严格来说比你已有的东西更差。
任何需要可验证的东西。 对于有分量的抽取,名单池必须是你公布的那个名单池。如果生成出来的名单被人追问某个名字从哪来,你是无法自圆其说的。
你不愿传输的数据。 提示词会通过网络发送给语言模型。请当作它可能会出现在第三方日志里。写“30 种蔬菜”,不要写任何包含参与者细节的内容。
实用说明
生成的条目会替换你当前的名单。 如果你已经输入了内容,先保存它。把生成的条目合并进手工构建的名单会产生重复项并弄乱来源,而这正是你在抽取中不想要的那种模糊。
输出偏向国际化和常见。 模型产出的是它认为可能的东西,所以生成的名字会倾向于文本中经常出现的名字。如果你需要一份反映某个特定本地群体的名单,生成数据到不了那里。
重新生成,而不是修补。 如果一份名单大体正确但语气不对,就调整提示词再跑一遍。编辑三十个条目里的十五个,比再试一次更慢。
不要对任何关键内容假定事实完整性。 模型被要求返回完整的枚举,通常也确实如此,但它是语言模型,不是数据库。对于必须完全准确的名单——法律实体、监管类别、任何你会被追责的东西——都要核实。
一句话概括这条边界
用 AI 来构建名单;用工具来让选择变得公平。这是两个独立的问题,而人们真正会去查的是抽取那一个。
抽取本身使用 crypto.getRandomValues(),而不是可预测的 Math.random(),所以选择与名单是如何构建的无关。公平性审计页面里有这套机制。
试一试
打开任意工具,点一下工具栏里的 AI 按钮,要求一份带有明确数量的具体名单。从你能核实的东西开始——一份首都名单、一份类别名单——先看看它表现如何,再拿它去依赖任何更长的内容。